TiTok 有意思的地方,是把生成模型的图像底稿,从一张按位置排好的网格,变成了一小串共同描述全图的编码。
生成模型通常不直接处理照片的每个像素,而先把图像换成更小的内部表示。其中一条常见路线,是把画面压成二维网格,每格存一个编码,叫作视觉 token。画新图时,模型先预测这些编码,再把它们还原成像素。
问题是,大半张蓝天依然占着许多格子。相邻区域的信息明明相似,编码数量却受网格尺寸约束。能不能少记一些,又留下足够的信息,把画面重新画出来?论文讨论的正是这件事。
TiTok 可以理解为一个“图像速记器”。它先把图像小块和一小组可学习的记录位置一起交给网络,让这些位置汇总全图信息;最后只保留这组记录,并映射成编码表里的编号。每个编号不再固定负责左上角或右下角。还原时,解码网络读取整串编号,把信息铺回画面。关键在于取消固定的位置对应,仅把二维网格拉直并没有这个效果。方法原文
训练也需要搭台阶:作者先让它学习现成图像编码器给出的编码,再固定前面的编码部分,微调负责还原图像的部分。生成新图则采用“填空”:从空白编码串出发,分几轮补全,最后解码成图。训练与生成流程
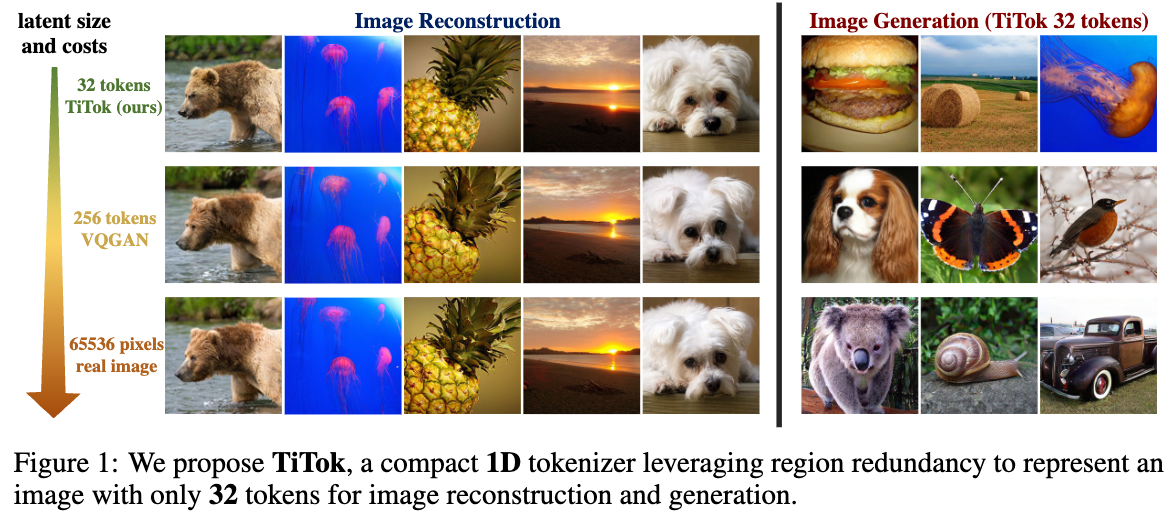
成没成?论文在 ImageNet 这个常用自然图像数据集上,确实把一张 256×256 图像表示成了 32 个编码。采用相同的填空生成网络、且都不加额外类别引导时,生成分布距离 gFID 从基线的 6.18 降到 3.15;这个数越低,表示生成图片整体统计越接近真实图片。它支持这条路线有效,却不保证每张图的细节都正确。实验表5
它值得继续追问的,是影像系统究竟该把算力花在哪里。以下是应用设想:创作软件或许可以先用短编码快速产出构图候选,选中后再精修;相册若能复用这种表示,或许能减少向生成助手传递参考画面的负担。视频系统也可能从缩短每帧表示中获益,但还得解决跨帧一致性。这些都需要另做实验。
代价同样明确:编码更少,细节更容易丢;更强的编码和解码网络也要消耗算力。论文主要验证按类别生成自然图像,视频扩展仍属未完成工作。32 个编码不是照片的无损压缩包,也不等于32个字节。对文字、面孔和需要留证的照片,系统仍须保留原件。这篇工作留下的判断是:适合模型生成的简短底稿,未必适合忠实保存一次拍摄。结果与局限