Lumiere 有意思的地方,是把“先画几个时刻,再补中间动作”,变成“让整段视频一起形成动作”。
想象让模型生成一个人走过街道。单张照片里,衣服、街景都能很漂亮;连起来,却可能忽快忽慢,脚步像突然换了节拍。论文发表时,一条常见路线是先生成相隔较远的关键帧,再由另一个模型补齐中间画面。这样省算力,但两个相似姿势之间,究竟迈了一步还是两步?后面的补帧模型只看一小段,很难替整段视频统一答案。
Omer Bar-Tal 等人在 Lumiere 论文里改变了这个分工。它借用已有文生图大模型的画图能力,加入学习运动的部分。所谓扩散生成,就是从噪声开始,反复修正,逐渐得到画面;这里每轮修正都覆盖整段低分辨率视频,而非只处理几个稀疏时刻。
但把所有画面一起算,内存怎么受得了?作者让网络在内部同时压缩画面的宽高和时间方向,在更小的表示上协调动作,再逐层展开。这种先收拢、再展开的结构叫“时空 U 形网络”。整段一起处理,不等于一次运算就出片:它仍要经过多轮去噪。方法原文
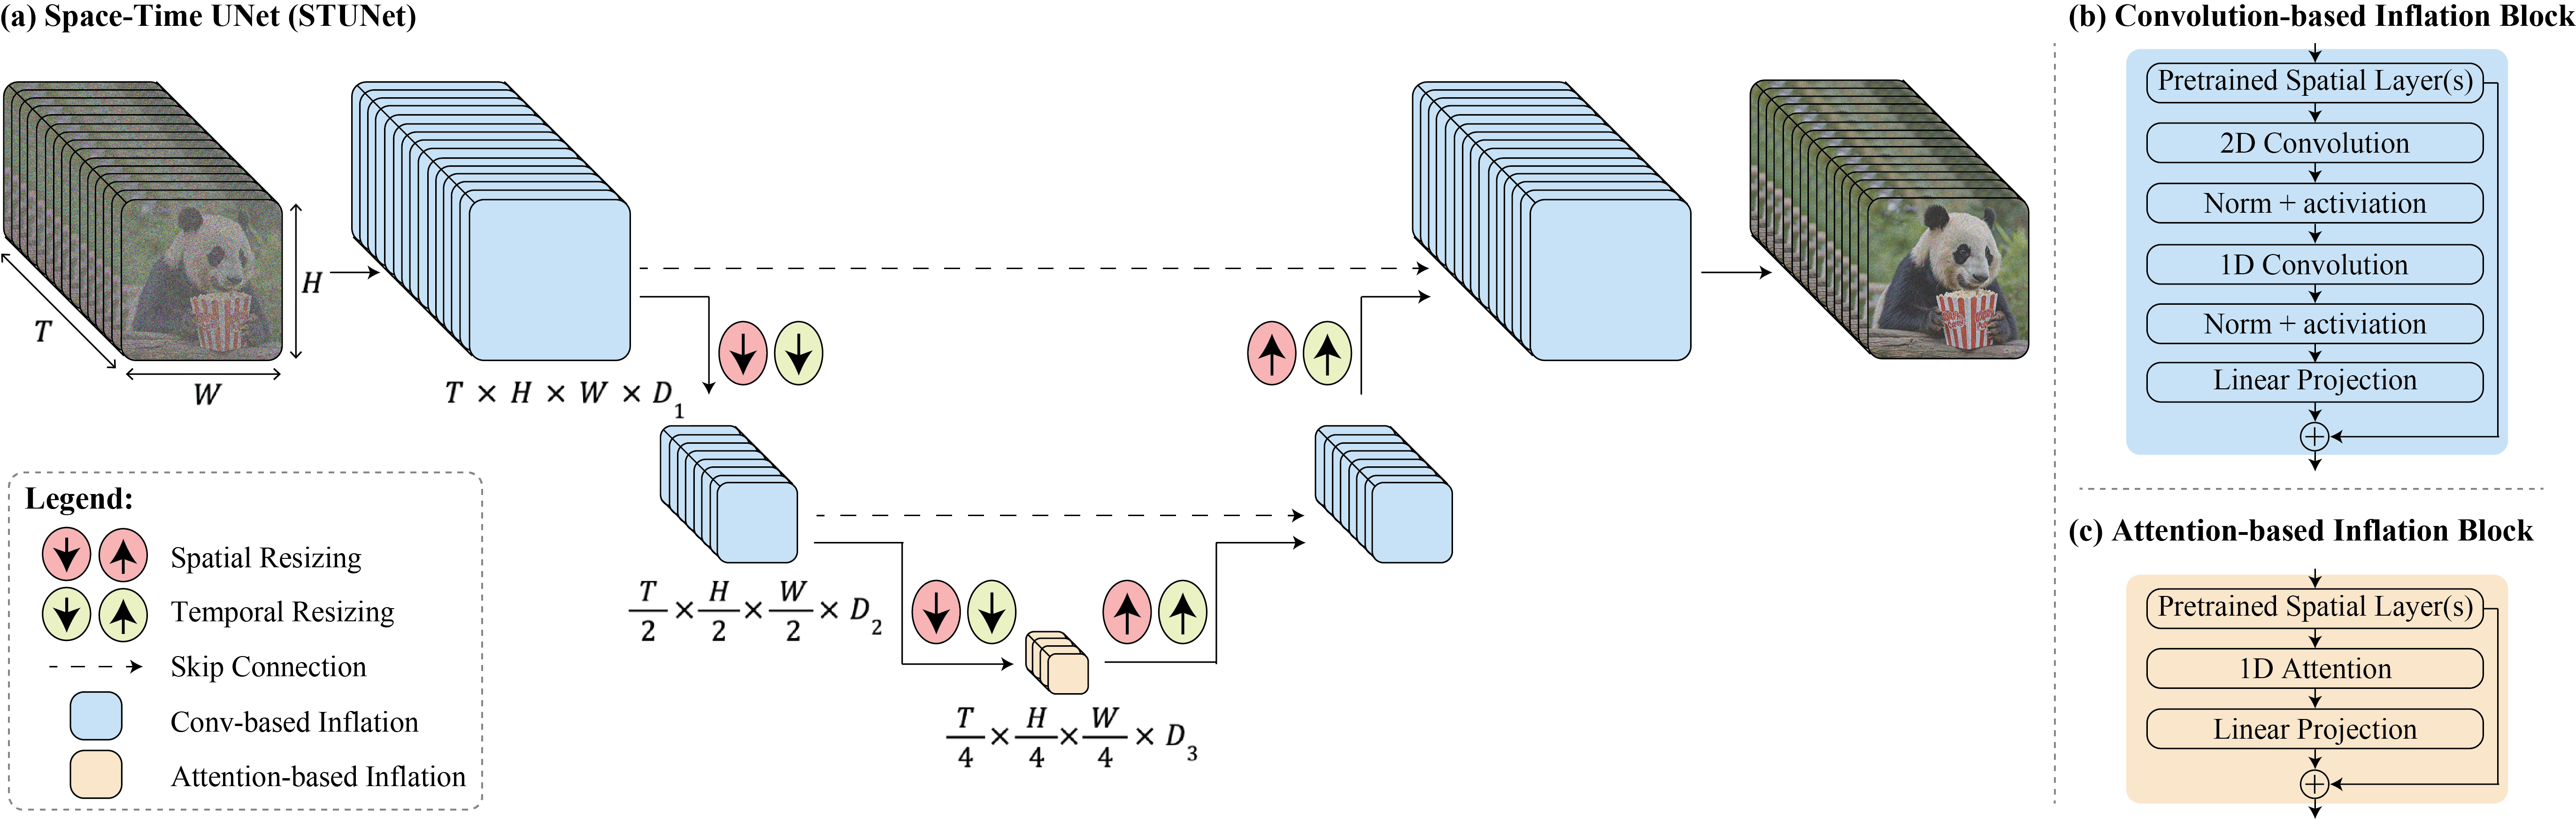
最后补清晰度时,系统仍受内存限制,需要分段处理。它让相邻片段有所重叠,并在每轮生成中融合重叠处的预测,减少接缝。
成没成?作者在两段视频二选一的人类评价中,报告 Lumiere 比所测对手更受偏好,考察的是画面质量与运动等方面。这支持了路线的可行性,却不能读成今天仍然领先:比较来自当年的模型版本,也不能单凭偏好证明物理运动正确。实验原文
项目演示还展示了让照片动起来、局部补画和视频风格化。由此可以设想,相册里圈出湖面,让水波动而岸边保持静止;广告制作中替换一个物件,让替换区域跟随整段动作。这里真正有产品价值的,是把用户的一次修改沿时间保持下去。这些是应用方向,演示尚不等于可稳定交付的编辑工具。
它的边界也明确:论文生成的是五秒片段,没有解决多镜头叙事和场景切换。产品验收因此还得追问:物体被遮住再出现,是否仍是同一个?局部改完,其他地方是否真的保住了?运动顺畅只是视频可信的一部分。论文局限