这篇不是给扩散模型再训练一个修图器,而是把模型生成时已经形成的“哪个词管哪块画面”,变成一条可直接拨动的修图轨道。
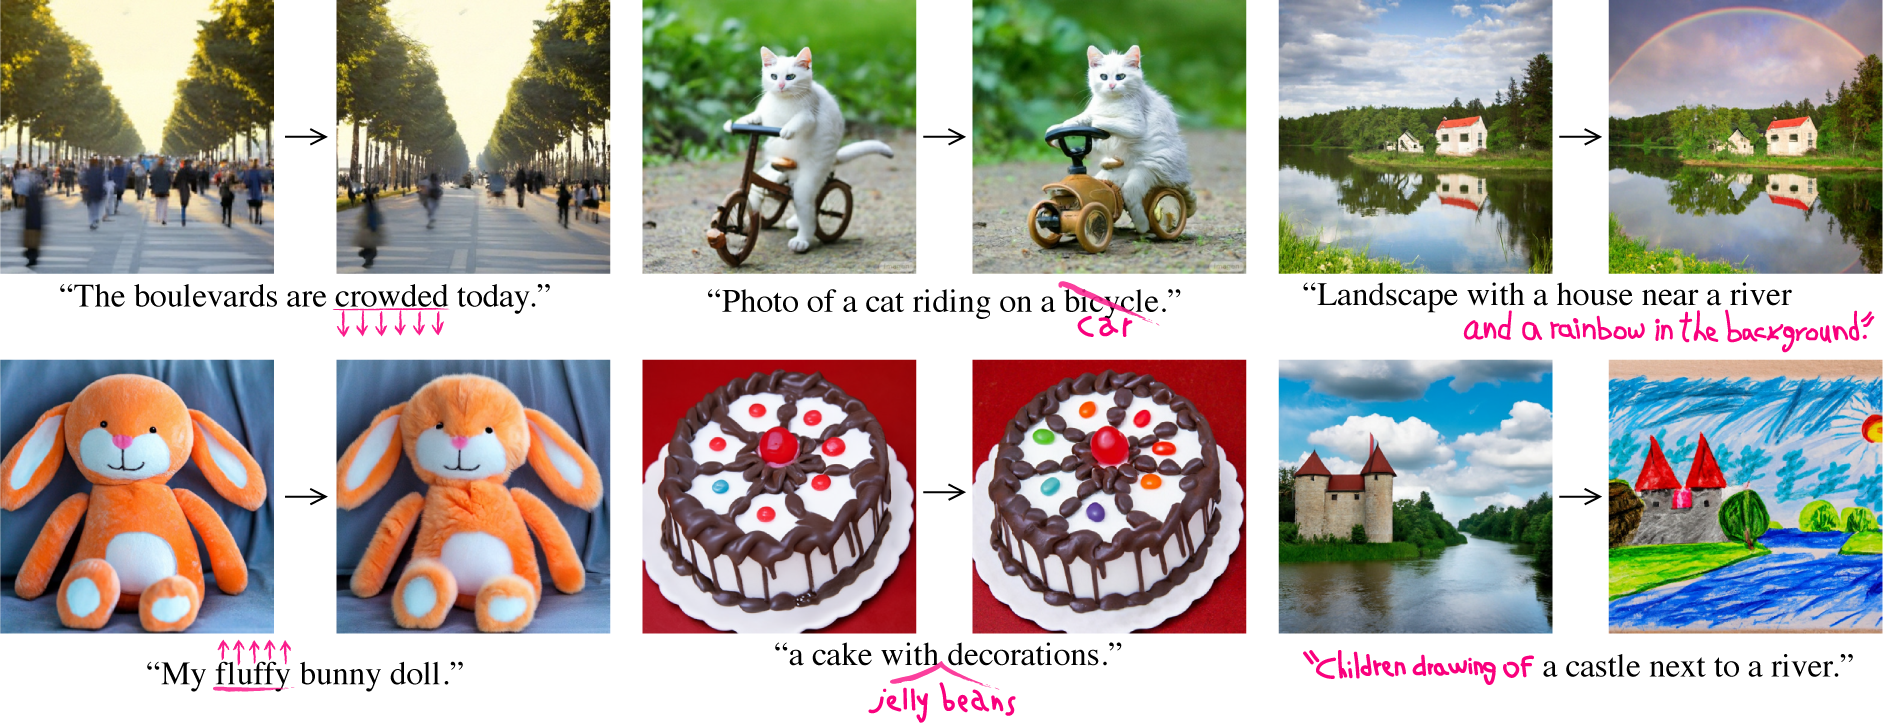
用文字生成图片时,改一个词看似应该只改一个物体:把“自行车”换成“三轮车”,背景、视角和猫都应留在原位。现实却是,即使沿用同一随机种子,模型也可能把整张图重新安排。传统修图通常让人先画选区,但选区只能规定“哪里能动”,并不知道原画面里的词、物体和布局怎样对应。文本编辑真正难的不是生成新内容,而是守住没有被要求改变的部分。
Prompt-to-Prompt 抓住了扩散模型内部的一份现成“施工图”。扩散模型,就是从噪点一步步还原出图像的生成器;交叉注意力,则是每一步里各个画面位置对提示词分别听多少的权重表。作者发现,这张表很大程度上决定了物体出现在哪里。于是生成原图和编辑图时,方法把原提示词的注意力图注入新一轮生成,让没改的词继续占据原位置,同时把新词的内容交给模型补出来。整个过程不需要重新训练,也不要求用户手画掩膜。
这套控制有三种直观动作:替换词,可以把一种物体换成另一种;增加描述,可以加雪、换光线或改风格;调高或调低某个词的注意力,可以像滑杆一样改变“毛茸茸”“拥挤”等属性的强弱。关键不是动作清单,而是它把自然语言从一次性的生成命令,改成了可反复修改的编辑界面。
作者用多组图像展示了构图保留、局部替换和风格变化,视觉结果支持这条机制确实能工作;但论文主要给的是定性案例,不是覆盖真实照片的大规模客观评测。在今天的指令修图工作流里,它仍提醒人们:控制能力未必来自更大的模型或再次训练,也可以来自对生成过程内部状态的直接利用。它最直接的价值,是让相册和修图软件把“换掉帽子、增加晚霞、雪再多一点”映射成可回退的语义操作;广告素材也能在同一构图上批量换商品、季节和画风。若把类似的词—位置轨道跨帧延续,还可能服务视频编辑,但时序一致性并不是这篇论文已经解决的问题。
边界也很清楚。真实照片必须先做“反演”,也就是把成片倒推回扩散模型的起始噪声;论文承认这种倒推常常无法精确重建原图。改动越涉及大幅几何变化,保留旧注意力越会妨碍新物体长对;放松保留又容易让背景漂移。因此它证明的是一个重要控制接口,而不是已经成熟的任意照片无损修图系统。